Unification des use cases de la Clean Architecture et d'agent IA (en Rust)
Introduction
J'aime conserver le domaine métier sous forme de use cases agnostiques (autant que possible !) et d'entités. Il y a plusieurs intérêts à utiliser cette forme spéciale, mais le principal de mon point de vue est que le use case inverse le flux du code (inversion de dépendance) : on appelle le use case pour qu'il réalise une fonction métier et c'est tout. Il rappellera notre implémentation de son interface de sortie pour nous donner le résultat. Le principe en synthèse :
Note : dans cet article, je simplifie certaines choses pour ne pas alourdir la compréhension.
Implémentation d'un use case en Rust
Prenons l'exemple d'un use case de virement bancaire :
/// Le solde de chaque compte, pour la démo:
type Accounts = BTreeMap<String, u32>;

/// Un trait pour tous les use case
trait UseCase {
    type Output;

    fn execute<P: OutputPort<Self::Output, String> + ?Sized>(self, accounts: &mut Accounts, out: &mut P);
}

pub struct Transfer {
    pub from: String,
    pub to: String,
    pub amount: u32,
}

impl UseCase for Transfer {
    type Output = String;

    fn execute<P: OutputPort<String, String> + ?Sized>(self, accounts: &mut Accounts, out: &mut P) {
        match self.transfer(accounts) {
            Ok(done) => out.success(done),
            Err(e) => out.failure(e),
        }
    }
}

impl Transfer {
    fn transfer(&self, accounts: &mut Accounts) -> Result<String, String> {
        let from = accounts.get_mut(&self.from).ok_or(format!("no account {}", self.from))?;
        if *from < self.amount { return Err(format!("{} has only {}", self.from, from)); }
        *from -= self.amount;
        *accounts.get_mut(&self.to).ok_or(format!("no account {}", self.to))? += self.amount;
        Ok(format!("{} sent {} to {}", self.from, self.amount, self.to))
    }
}
Un use case est une simple struct Rust qui utilise comme port de sortie un trait générique ayant deux types : ce que le use case transmet quand il réussit, et ce qu'il transmet sur erreur :
trait OutputPort<T, E> {
    fn success(&mut self, value: T);
    fn failure(&mut self, error: E);
}
Il possède une méthode publique unique pour faire l'action : execute, qui transmet le résultat à out, par success ou failure.
Appel du use case
let mut state = Accounts::default();
state.insert("Alice".into(), 100);
state.insert("Bob".into(), 0);

let mut out = FnOutputPort {
    on_success: |done: String| println!("{done}"),
    on_failure: |e: String| println!("refusé : {e}"),
};
use_cases::Transfer { from: "Alice".into(), to: "Bob".into(), amount: 10 }.execute(&mut state, &mut out);
La forme syntaxique Rust est alambiquée, mais c'est en fait assez simple : deux lambdas sont déclarées et réalisent l'implémentation de l'interface de sortie du use case pour obtenir le résultat. Une seule implémentation de FnOutputPort, réutilisable partout, suffit, avec une fermeture par sortie :
struct FnOutputPort<S, F> { on_success: S, on_failure: F }

impl<T, E, S: FnMut(T), F: FnMut(E)> OutputPort<T, E> for FnOutputPort<S, F> {
    fn success(&mut self, value: T) { (self.on_success)(value) }
    fn failure(&mut self, error: E) { (self.on_failure)(error) }
}
Test du use case
Un test se branche de la même façon, avec un FnOutputPort qui garde le résultat pour le vérifier. Le use case ne voit pas la différence :
let mut state = Accounts::default();
state.insert("Alice".into(), 100);
state.insert("Bob".into(), 0);

let mut out = FnOutputPort { on_success: |_: String| {}, on_failure: |e: String| panic!("{e}") };
use_cases::Transfer { from: "Alice".into(), to: "Bob".into(), amount: 30 }.execute(&mut state, &mut out);

assert_eq!(state["Alice"], 70);
assert_eq!(state["Bob"], 30);
Intégration automatique d'agent IA (LLM)
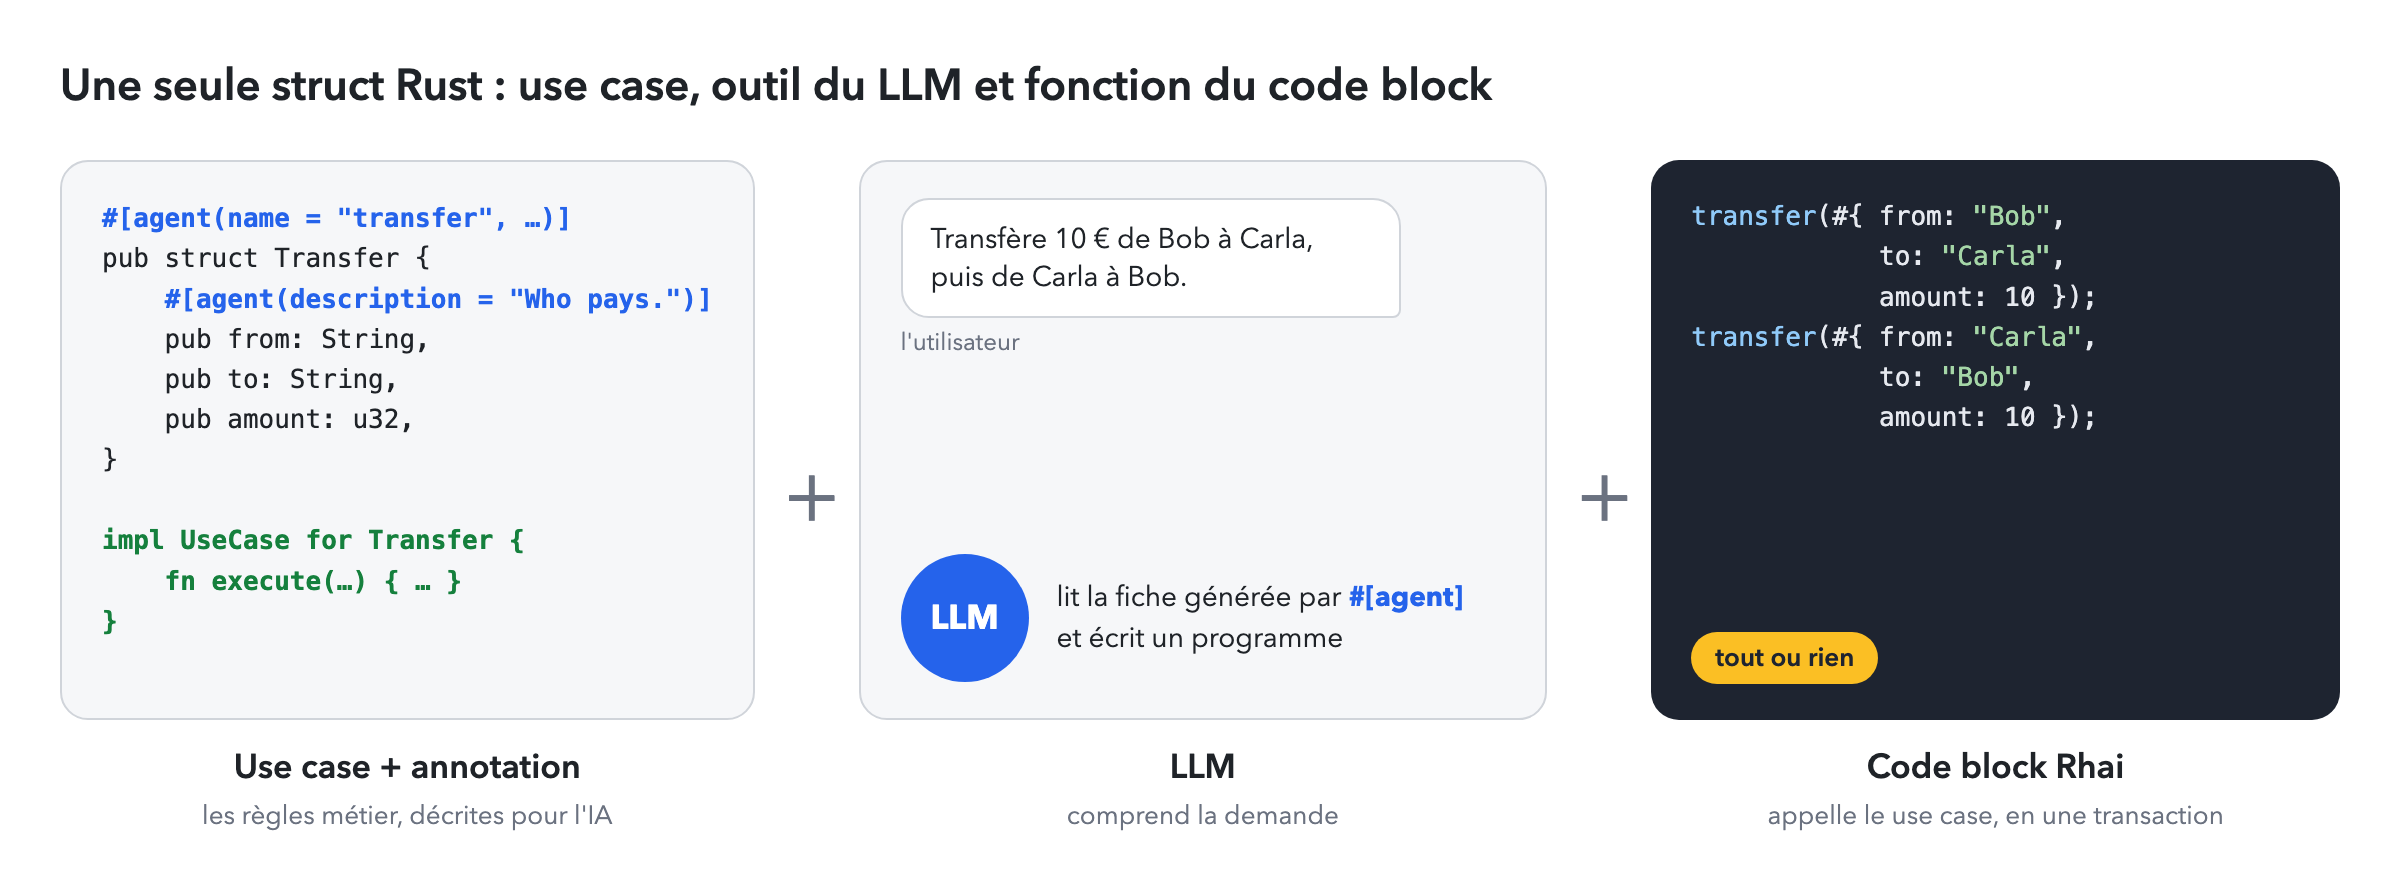
L'idée est la suivante : j'aimerais que mon agent IA puisse utiliser mes use cases comme des Tools. Précisons tout de suite que, dans une version professionnelle, il y a une façade entre les tools « use case » et les agents IA afin de former un harnais durci, mais pour simplifier, considérons que l'agent IA appelle les use cases directement. La struct du use case va être augmentée d'annotations dédiées à l'IA :
#[agent(name = "transfer", description = "Send money from one account to another. Refused if the payer would go below zero.")]
pub struct Transfer {
    #[agent(description = "Who pays.")]
    pub from: String,
    #[agent(description = "Who receives.")]
    pub to: String,
    #[agent(description = "How much, in whole euros.")]
    pub amount: u32,
}
Ce que génère #[agent] :
{
  "name": "transfer",
  "description": "Send money from one account to another. Refused if the payer would go below zero.",
  "parameters": {
    "type": "object",
    "properties": {
      "from": { "type": "string", "description": "Who pays." },
      "to": { "type": "string", "description": "Who receives." },
      "amount": { "type": "integer", "description": "How much, in whole euros." }
    },
    "required": ["from", "to", "amount"]
  }
}
Dans une version complète, on établirait un prompt système (annuaire) avec une description synthétique renvoyant à la description détaillée des use cases, afin de limiter la quantité de tokens employée.
Par exemple, l'annuaire envoyé à chaque tour ne tient qu'une ligne par use case :
You act on bank accounts through the use cases below.
Before using one, call find_actions with its name to get its full sheet.
- transfer [write] Send money from one account to another.
- deposit [write] Add money to an account.
- get_balance [read] The balance of an account.
- close_account [write] Close an account.
Le modèle ne demande la fiche complète (le JSON ci-dessus) que du use case dont il a besoin : find_actions(["transfer"]).
Cet annuaire est lui aussi généré automatiquement, à partir des annotations.
Agent IA et évaluation interprétée et scopée
L'intérêt d'évaluer les use cases dans un programme est de permettre le traitement des exceptions et des rollbacks sur une seule transaction ACID. On va donc demander au LLM de nous écrire un programme répondant au prompt de l'utilisateur, puis on évalue ce programme. Le langage dynamique choisi ici est Rhai (rhai.rs).
Imaginons le prompt suivant : « Transfère 10 euros de Bob à Carla, puis de Carla à Bob. »
Le programme Rhai écrit par le modèle :
transfer(#{ from: "Bob", to: "Carla", amount: 10 });
transfer(#{ from: "Carla", to: "Bob", amount: 10 });
Chaque use case annoté devient une fonction Rhai du même nom. Quand le programme appelle transfer(#{ ... }), ses paramètres remplissent un Transfer, puis execute est appelé : c'est exactement le même use case qu'au début de l'article, celui de l'appel direct et du test.
Le programme est évalué en une seule fois, sur une copie des comptes. Si un appel échoue, c'est la totalité du programme qui est annulée : les virements déjà faits sont défaits, et les comptes restent tels qu'ils étaient avant.
Par exemple, ce programme vire 20 € à Bob, à Carla, puis à Dan, qui n'a pas de compte :
for friend in ["Bob", "Carla", "Dan"] {
    transfer(#{ from: "Alice", to: friend, amount: 20 });
}
Le troisième virement échoue, et les deux premiers sont annulés avec lui :
{
  "changed": "nothing",
  "error": "Runtime error: transfer: no account Dan (line 3, position 13)"
}
Pour recevoir le résultat, l'agent fait comme le test : il fournit sa propre implémentation du port de sortie. Le use case l'appelle par success ou failure, sans savoir qu'il parle à une IA, et le résultat repart vers le modèle en JSON. On retrouve l'inversion de dépendance de l'introduction : l'IA n'est qu'un appelant de plus.
Deux garde-fous complètent le tout. Le programme n'est évalué qu'après la confirmation de l'utilisateur. Et Rhai ne peut appeler que les fonctions qu'on lui a enregistrées : les use cases, et rien d'autre (ni fichier, ni réseau). Un plafond sur le nombre d'appels et d'opérations évite aussi qu'un programme tourne sans fin.
Conclusion
Au final, une demande à l'agent suit toujours le même chemin :
- L'utilisateur écrit sa demande.
- Le modèle lit l'annuaire et demande la fiche des use cases dont il a besoin.
- Il écrit un programme Rhai qui les appelle.
- L'utilisateur confirme.
- Le programme est évalué, tout ou rien.
- Le résultat revient au modèle, qui répond à l'utilisateur.
C'est tout l'intérêt de l'approche : en Rust, le use case de la Clean Architecture et l'outil de l'agent IA ne font qu'un. Il n'y a pas d'un côté le code métier, et de l'autre une définition d'outil écrite à la main pour le modèle : c'est la même struct Transfer. Ses champs sont à la fois les paramètres du use case et ceux de l'outil, et l'annotation #[agent] n'ajoute que ce que le modèle doit lire.
Le compilateur garde cette unité. Un paramètre ajouté au use case apparaît tout seul dans la fiche de l'IA. Un champ sans description, ou d'un type que la macro ne connaît pas, ne compile pas. Le type du résultat est vérifié entre le use case et ce qui repart vers le modèle. La définition de l'outil ne peut donc jamais s'écarter du code qu'elle appelle.
Les règles métier restent écrites une seule fois, dans les use cases. L'UI, les tests et l'agent passent tous par elles, et l'agent ne peut rien faire que les use cases n'autorisent.
Je garde le code complet de la démonstration à disposition : écrivez-moi si vous souhaitez le recevoir.